클라우드플레어, AI 검색 과금서 '정보 검색'과 '모델 비용' 분리
클라우드플레어 AI Search가 2026년 11월 1일부터 사용량 과금을 시작합니다. 자기 데이터로 앱·에이전트 검색을 만드는 상품으로, 임베딩·재정렬은 요금에 포함되고 답변 생성 등은 해당 서비스에서 청구됩니다. 수집량은 청크 겹침과 OCR도 반영하며, 외부 AI 답변의 사이트 인용과는 별개입니다.
AI 소식
생성형 검색 시대의 미디어
클라우드플레어 검색 결과 7건
클라우드플레어 AI Search가 2026년 11월 1일부터 사용량 과금을 시작합니다. 자기 데이터로 앱·에이전트 검색을 만드는 상품으로, 임베딩·재정렬은 요금에 포함되고 답변 생성 등은 해당 서비스에서 청구됩니다. 수집량은 청크 겹침과 OCR도 반영하며, 외부 AI 답변의 사이트 인용과는 별개입니다.
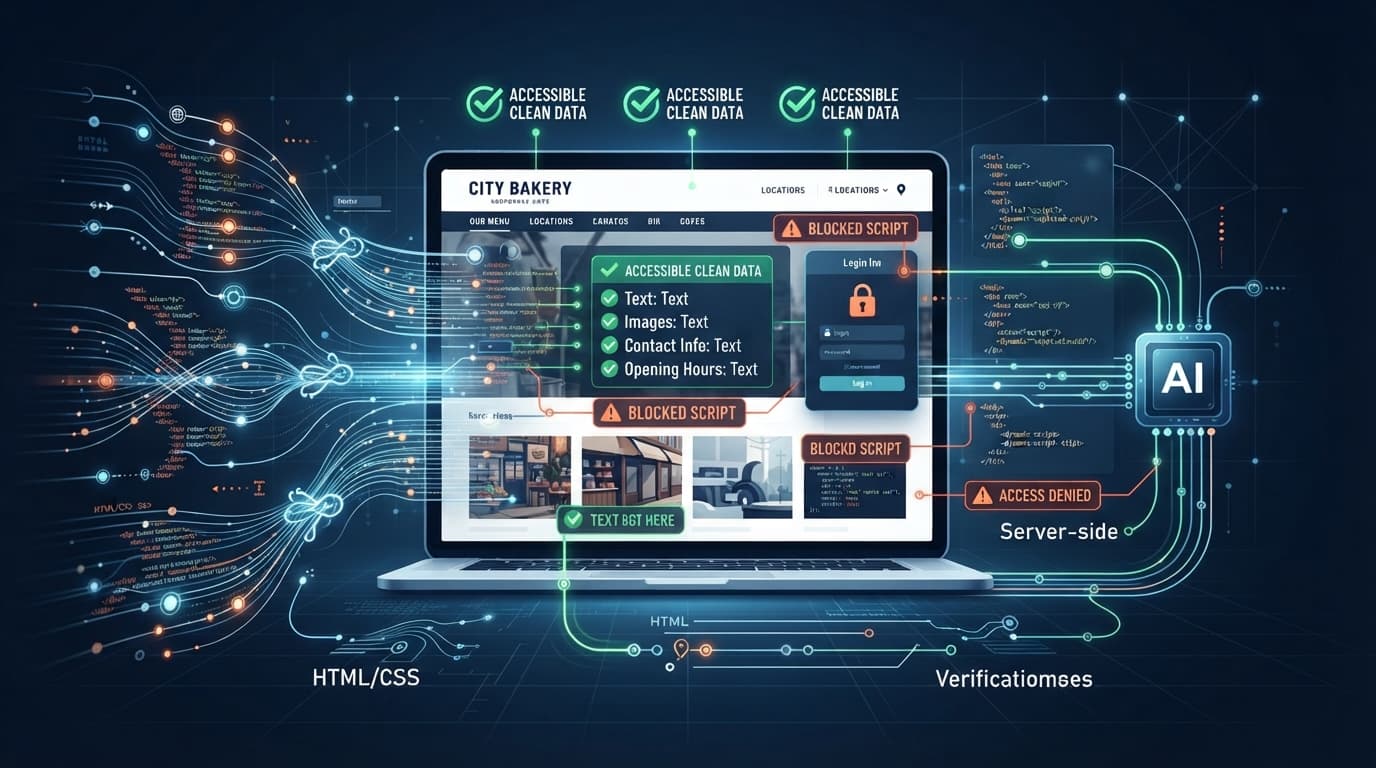
AI 검색이 로컬 비즈니스 정보를 인용하기 위해서는 크롤러 접근 허용과 서버사이드 렌더링이 필수적이라는 분석이 나왔습니다. 보안 설정의 크롤러 차단과 클라이언트 사이드 자바스크립트에 의존한 콘텐츠는 인용 누락을 부르며, 방치된 구형 페이지와 스키마 불일치 역시 잘못된 정보 생성의 원인으로 지목됩니다.
AI 검색이 트래픽을 돌려주지 않으면서 웹사이트들의 AI 크롤러 차단이 확산되고 있습니다. 고품질 1차 출처가 차단에 나서면서 AI 검색이 저품질 및 AI 생성 콘텐츠를 인용하게 되는 구조적 악순환이 제기됩니다.
대규모 언어 모델(LLM)을 일상적으로 사용하기 시작한 이용자는 약 20주의 적응기를 거친 뒤 전통적 검색 엔진 이용을 21.7% 줄인 것으로 나타났습니다. 질문형 검색이 챗봇과 검색 내 AI 요약으로 흡수되면서 하위권 소형 웹사이트의 트래픽이 41.8% 감소했습니다.
웹 트래픽의 절반 이상을 AI 봇이 차지하면서 웹사이트들의 AI 크롤러 차단이 가속화되고 있습니다. 클라우드플레어가 광고 페이지 대상 AI 크롤러 기본 차단을 예고한 가운데, 고품질 원본의 이탈과 AI 생성 콘텐츠 인용 증가가 AI 검색 품질의 구조적 악순환을 낳고 있습니다.
AI 검색과 요약 기능 확산으로 유입 트래픽이 급감하자 웹사이트들의 AI 크롤러 차단이 본격화되고 있습니다. 고품질 원천 사이트의 차단이 늘어날수록 AI 검색 결과가 저품질·AI 생성 웹사이트를 인용하게 되는 악순환 구조가 지적됩니다.
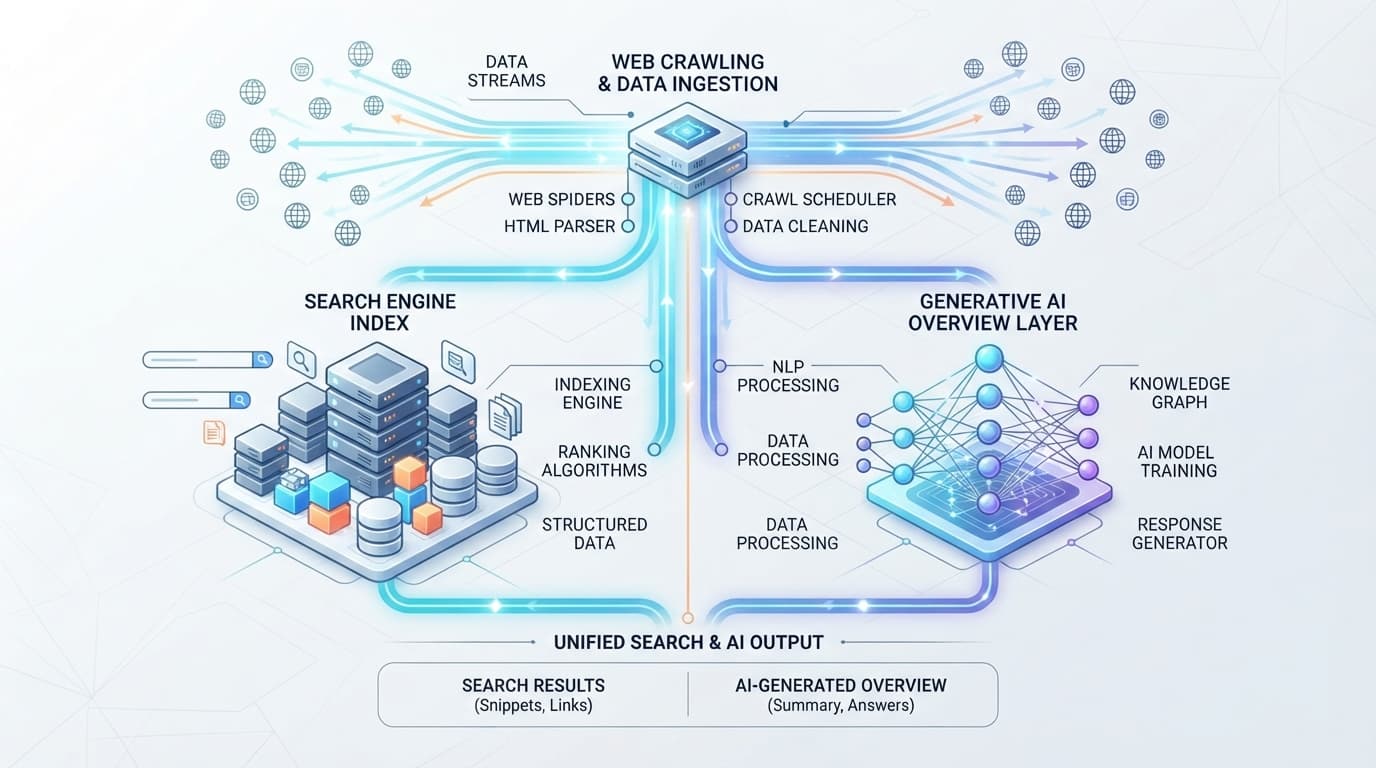
구글봇이 독립 프로그램이 아닌 사내 공용 수집 플랫폼의 클라이언트로 작동한다는 구조가 공개됐습니다. 단일 HTTP 요청이 검색 색인과 AI 개요 인용을 동시에 생성하는 가운데, 2MB 크롤링 제한과 AI 데이터 분리 권한을 둘러싼 기술적·규제적 쟁점이 커지고 있습니다.