쉽게 말하면
스탠퍼드 대학교 연구진이 2023년 생성형 검색 엔진 4곳을 측정한 연구에 따르면, AI가 작성한 문장 중 출처의 뒷받침을 제대로 받는 비율은 평균 51.5% 수준이었습니다. 또한 AI가 제시한 인용 링크 4개 중 1개꼴(74.5%)로 본문 내용과 완전히 일치하지 않는 것으로 나타났습니다. 이번 사건처럼 특정 정보가 인터넷에 거의 없는 상황에서는 AI가 소셜미디어의 단편적인 표현을 합성해 사실과 다른 결과를 낼 위험이 커집니다.
투자 사기 혐의자, 구글 AI 검색서 프로 미식축구 선수로 둔갑
연방 검찰에 투자 사기 혐의로 기소된 데이존 러브(Daejon Love)가 구글 AI 오버뷰(AI Overview)에서 미국 프로미식축구(NFL) 샌프란시스코 포티나이너스(49ers) 선수로 생성·소개된 사실이 대학 언론 더 파이오니어(The Pioneer)의 보도로 알려졌습니다. 연방 진술서에 따르면 구단과 NFL 측은 러브가 해당 조직에 고용된 적이 없다고 밝혔습니다.
수사 당국이 확인한 바에 따르면, 러브는 데이팅 앱을 통해 만난 이들에게 자신을 운동선수라고 속이며 금전을 요구했습니다. 러브는 구글 AI 오버뷰 결과 화면을 캡처해 소셜미디어에 공유하며 자신의 신원을 입증하는 수단으로 사용하기도 했습니다.
데이터 공백과 소셜미디어 문구 인용
구글 대변인은 이번 사안에 대해 다음과 같이 설명했습니다.
"검색 기능은 웹상에 존재하는 정보를 반영하는 핵심 랭킹 시스템에 기반합니다. 이처럼 드문 질문의 경우 표시할 고품질 정보가 제공되지 않는 경우가 많습니다."
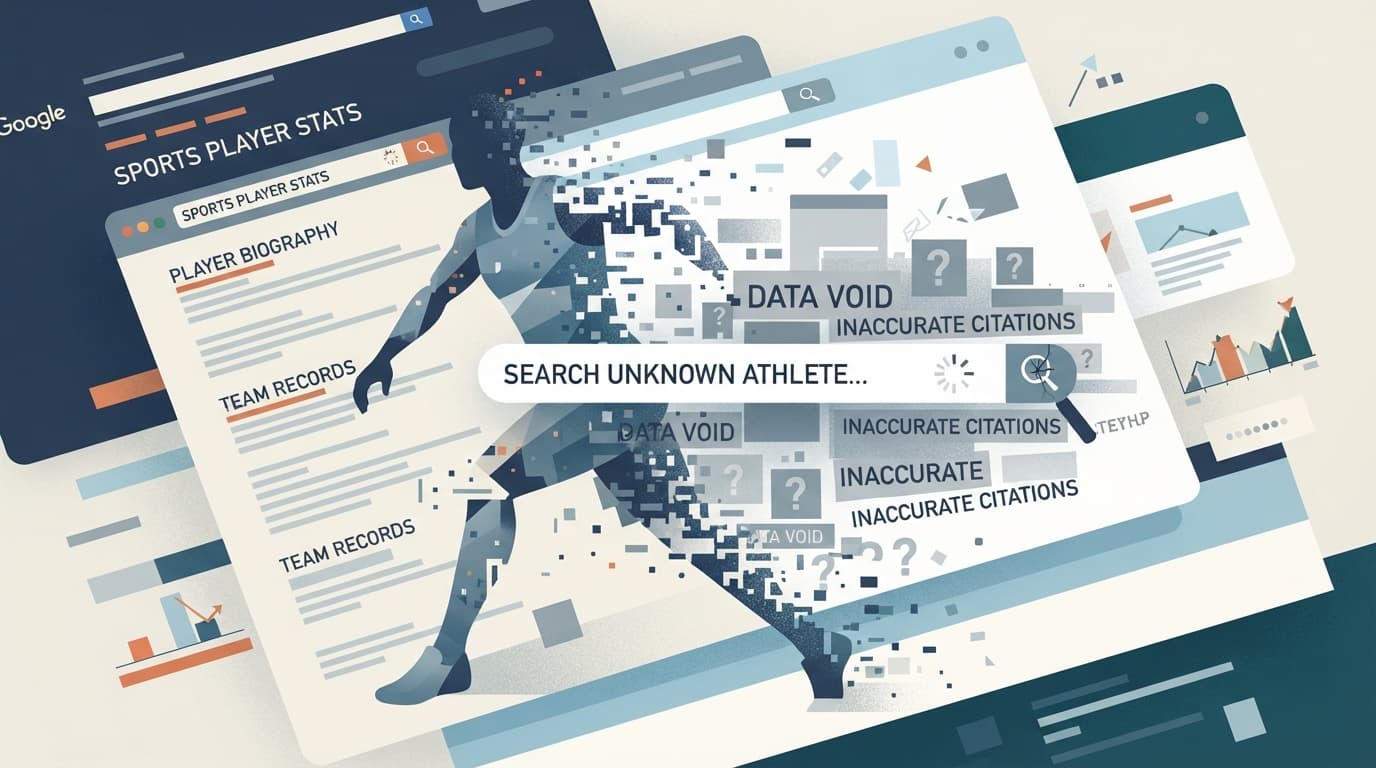
구글 대변인은 이를 정보가 부족한 '데이터 공백(data void)' 현상으로 규정했습니다. 마이클 골레비에프스키와 다나 보이드의 보고서에 따르면, 데이터 공백 상태에서는 낮은 품질이나 권위가 없는 콘텐츠가 유일하게 사용 가능한 정보가 될 수 있습니다.
실제로 미 연방수사국(FBI) 진술서에 첨부된 검색 결과에는 러브가 NFL 와이드 리시버로 기재된 링크드인 프로필과 10만 회 가까운 조회수를 기록한 틱톡 영상이 포함되어 있었습니다. 과거 구글 AI 오버뷰 화면에 나타난 문구("포지션, 계약, 팀 동료와의 문자 습관")는 틱톡 영상의 소개 문구와 유사했습니다. 다만 구글이 해당 틱톡 영상을 직접 참조했는지, 혹은 러브가 AI 시스템을 겨냥해 의도적으로 작업했는지는 공식적으로 확인되지 않았습니다.
오류 설명 과정에서 드러난 2차 인용 왜곡
문제가 된 것은 오류의 원인을 설명하는 과정에서도 나타났습니다. 구글 AI 오버뷰에 해당 오류에 대해 질의했을 때, 시스템은 러브가 검색 색인 시스템을 조작했다거나 '알고리즘 합의 공격(algorithmic consensus attack)'을 감행했다는 등의 분석을 사실처럼 제시했습니다.
그러나 AI가 근거로 든 FBI 진술서와 언론 보도는 러브의 사기 혐의나 AI가 생성한 허위 신원 문제를 다뤘을 뿐, 구글의 내부 생성 과정이나 시스템 조작 여부를 기술적으로 증명하지는 못했습니다. 출처가 신뢰할 만한 기관이어도, AI 시스템이 그 출처가 담고 있는 사실 범위를 넘어서는 단정적인 결론을 도출한 셈입니다.
학계에서도 생성형 검색 엔진의 인용 불일치 문제는 꾸준히 제기되어 왔습니다. 스탠퍼드 대학교 넬슨 F. 리우(Nelson F. Liu), 장톈이(Tianyi Zhang), 퍼시 량(Percy Liang) 연구진이 2023년 발표한 논문에 따르면, 당시 빙 챗, 니바AI, 퍼플렉시티, 유챗 등 4개 생성형 검색 엔진을 조사한 결과 생성된 문장의 평균 51.5%만이 인용 출처에 의해 완전히 뒷받침되었으며, 전체 인용 중 관련된 문장을 실질적으로 뒷받침하는 비율은 74.5%에 그쳤습니다.
출처 유무와 기술적 인과관계의 간극
구글 대변인은 "엄격한 정책과 사기 방지 시스템을 갖추고 있지만, 흔하지 않은 검색어를 찾아볼 때는 웹상의 정보를 재확인할 것을 권장한다"고 덧붙였습니다. 또한 신뢰할 수 있는 정보가 확보되면 검색 기능 결과가 달라진다고 밝혔습니다.
하지만 구글은 초기 허위 AI 오버뷰가 구체적으로 어떤 출처를 조합해 만들어졌는지, 사후 오류 해명에서 출처 범위를 벗어난 추론이 발생한 원인은 무엇인지에 대한 기술적 세부사항은 공개하지 않았습니다.
이 사이트가 보는 지점
이번 사례는 웹상에 권위 있는 문서가 없는 '데이터 공백' 환경에서 AI 검색이 신뢰할 수 없는 소셜미디어 텍스트를 무비판적으로 합성해 사실로 둔갑시키는 경로를 보여줍니다. 더 주목할 점은 오류를 자체 해명할 때조차 신뢰할 수 있는 출처를 가져와 출처 내용 이상의 기술적 결론을 지어내는 2차 환각 현상입니다. 이는 출처 링크의 존재 여부만으로는 AI 생성 답변의 진위를 담보할 수 없음을 드러내며, AI 검색 3사 인용 오차·모델 명세 비교에서 다뤄진 생성 엔진의 인용 불일치 문제가 검색 신뢰도에 미치는 현실적 위험을 나타냅니다.