기본 학습 포함과 명시적 동의 사이의 차이
인공지능 서비스의 이용자 데이터 처리 방침이 제공 업체와 계약 계층에 따라 뚜렷하게 나뉘고 있습니다. 2026년 10월 17일 IT 매체 테크인사이더가 보도한 개인정보 분석 내용에 따르면, 오픈AI는 무료(Free)를 비롯해 Go, Plus, Pro 등 소비자용 서비스 전반에서 사용자의 입력 대화와 콘텐츠를 모델 개선 및 학습에 기본적으로 활용하도록 설정해 두고 있습니다. 오픈AI 사용자가 학습 제외를 원할 경우 '프로필 → 설정 → 데이터 제어' 메뉴로 이동해 '모두를 위한 모델 개선' 설정을 직접 꺼야 합니다. 다만 피드백 버튼을 누를 경우 해당 대화가 다시 학습 대상으로 포함될 수 있으며, 임시 채팅의 경우 모델 학습에서는 배제되나 안전성 검토 목적으로 최대 30일간 보관될 수 있다고 분석은 짚었습니다.
반면 앤트로픽의 클로드(Claude)는 소비자 서비스에서 사용자가 개인정보 설정을 통해 명시적으로 허용한 경우에만 모델 개선에 데이터를 활용하는 '옵트인(opt-in)' 방식을 택하고 있습니다. 분석 업체 패럴렉트(Parallect)의 2026년 10월 AI 구독 보고서에서도 구글, xAI, 메타 등 다수 기업의 일반 소비자 계층이 보호 기본 설정을 두지 않는 것과 비교해 앤트로픽이 이용자 허락을 전제로 삼고 있다고 설명했습니다.
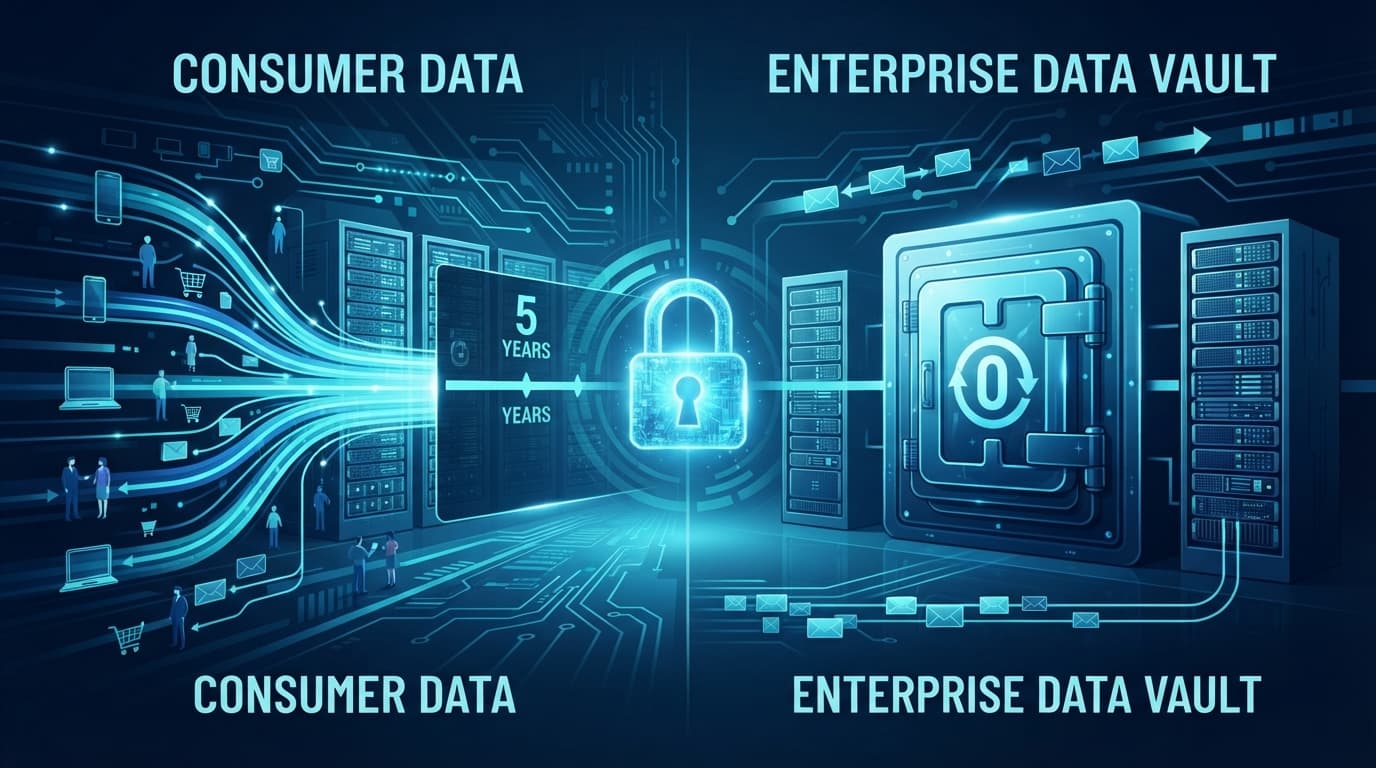
동의 시 최장 5년 보관… 기업용은 '데이터 무저장' 내세워
그러나 앤트로픽의 동의 방식 뒤편에는 장기 보관 조건이 있습니다. 테크인사이더의 2026년 10월 분석에 따르면, 사용자가 모델 개선에 동의할 경우 비식별 처리된 데이터가 앤트로픽의 학습 파이프라인 안에서 최대 5년 동안 보관될 수 있습니다. 신뢰 및 안전(Trust and Safety) 목적으로 분류된 콘텐츠의 경우에는 이용자의 설정 선택과 무관하게 2년에서 7년 동안 유지될 수 있는 것으로 나타났습니다. 앤트로픽은 2026년 중반 고성능 모델 대화 전반에 30일 보관 정책을 의무화하면서 논란을 겪기도 했습니다.
이러한 소비자용 정책과 달리, 기업(Enterprise)용 상품 시장에서는 데이터 무저장(Zero Data Retention, ZDR)이 영업 기준으로 자리 잡고 있습니다. 오픈AI는 2026년 8월 기업용 고객 데이터에 대해 모델 학습 배제 및 무저장 정책을 재확인했고, 안전 제어 기능인 프라이빗 세이프티 프로세싱을 예고했습니다. 앤트로픽 역시 2026년 9월 무저장 정책과 함께 고객 자체 클라우드 내에 데이터를 저장할 수 있는 기업용 옵션을 도입했습니다.
검색과 워크플로에 기본 탑재되는 AI 도구 점검 필요
일반 이용자 환경에서는 인공지능 요약 기능이 기본 탑재되면서 데이터 노출 경로가 넓어지고 있습니다. 구글 검색에서 기본 노출되는 AI 개요(AI Overviews) 기능이나 기기 전반에 결합된 보조 도구들이 대표적입니다. 영국 AOL이 2026년 10월 16일 발표한 디지털 정리 안내서에서는 사용하지 않는 인공지능 플랫폼 구독을 해지하고, 검색어 끝에 '-AI'를 덧붙여 생성형 요약을 배제하는 등 데이터 노출 범위를 주기적으로 점검할 것을 권고했습니다.
동시에 모델 출시 속도도 이어지고 있습니다. 2026년 9월 10일 딥시크(DeepSeek)는 자체 호스팅이 가능한 100만 토큰 문맥 지원의 'DeepSeek-V4.1-Flash'를 MIT 라이선스로 배포했으며, 구글 딥마인드는 9월 30일 공개한 '제미나이 4 아르곤(Gemini 4 Argon)'을 10월 13일 정식 출시했습니다. 오픈AI는 9월 29일 데브데이에서 GPT-6.1 Sol을 공개했고, 앤트로픽은 10월 7일 클로드 하이쿠 5.5를 출시하는 등 새로운 모델 적용이 잇따르고 있습니다.
이 사이트가 보는 지점
소비자용 AI와 기업용 AI의 데이터 보관 격차가 커지면서, AI 검색과 챗봇이 어떤 데이터를 참조하고 학습하는지 파악하는 작업이 더욱 복잡해졌습니다. 과거 구글 AI 끄면 캘린더 연동 포기… AI 개요는 유지에서 다뤘듯 일반 검색 인터페이스에서는 생성형 결과를 완전히 통제하기 어려운 구조가 굳어지고 있습니다. 개별 이용자 프롬프트가 최장 5년간 모델 개선 파이프라인에 머무는 반면 기업 환경은 무저장(ZDR)으로 분리됨에 따라, 향후 AI 인용과 답변 생성에 어떤 성격의 데이터 풀이 지속적으로 축적·반영되는지 정책적 추적이 필요합니다.